

【Kaggle コンペで銀メダル獲得!】ROGII - Wellbore Geology Prediction 参加記
 この記事をシェアする


オートノマス・ネットワーク本部に所属する、AIエンジニアの柴田です。
2026年5月~8月に開催されたKaggleコンペ『ROGII - Wellbore Geology Prediction』に参加し、銀メダル(68位/6125チーム)を獲得することができました。
また、ドメイン知識に乏しい分野のコンペに挑むうえで、生成AIの活用は不可欠でした。生成AIが非常に有用な場面もあれば、活用するうえでの課題(人間・AI双方)もありました。
本稿は、機械学習コンペにおける生成AI活用方法・課題意識を総括し、その後実際のコンペの技術的な内容を深堀りしたものとなっています。
まず、生成AIの活用と課題意識を総括します。
機械学習コンペにおける生成AIの活用・課題意識
特に以下のような点において生成AIは非常に効果的でした。
- 学習パイプライン・提出パイプラインの構築
- 考案したアイデアの実装
- データ拡張等、モデル性能向上のアイデア出し
一方で以下のような点においては課題がありました。
- 大方針の検討
- 既存のコードやコンテキストに引っ張られてしまい、有望なアイデアについては粘り強くやらせないとすぐに諦める傾向がありました。
- 精緻なデバッグ
- 意図せずバグを埋め込んでしまい、最終盤まで気づけないことがありました。
特に、2点目の精緻なデバッグについては、人間側(筆者)が実装の確認をおろそかにしてしまうことにも原因があったと考えています。どうしても実験が先行してしまいがちですが、常に実装を注意深く観察し、「自分でも書ける」状態を維持しなくてはならないと反省しました。
それでは、ここからはコンペの技術的な内容を振り返っていきます。
コンペ概要
本コンペはROGIIにより開催されました。ROGIIは、2013年に設立された米国テキサス州ヒューストンに本社を置く、石油・天然ガス開発(上流分野)向けの地質解析・掘削 ソフトウェア開発企業です。水平坑井のジオステアリング(掘削誘導)ソフト「StarSteer」や、リアルタイムコラボレーションを可能にする「Solo Cloud」などを提供しています。
コンペの目的
本コンペは、水平坑井(すいへいこうせい)における、True Vertical Thickness (TVT)の予測精度を競うものとなっています。まず、「水平坑井」と「TVT」の2つの単語について簡単に解説します。
水平坑井
石油や天然ガスを採取する際、従来は地面に対して垂直、あるいは斜めに掘り進めるのが主流でした。しかし、特にシェールガス(およそ、地下1000m以深のシェール層から採れるガス)の開発においては、従来手法の採用は困難でした。シェール層は浸透率が低く、従来手法で得られる接触面積では経済的な抽出をすることはできませんでした。その中で開発されたのが水平掘削技術です。水平掘削では、ターゲットとなる地層付近まで掘り進めた後、地層に対して水平に更に掘削していきます。これにより、シェール層との接触面積を大幅に増やすことができ、生産量の増加につながりました。
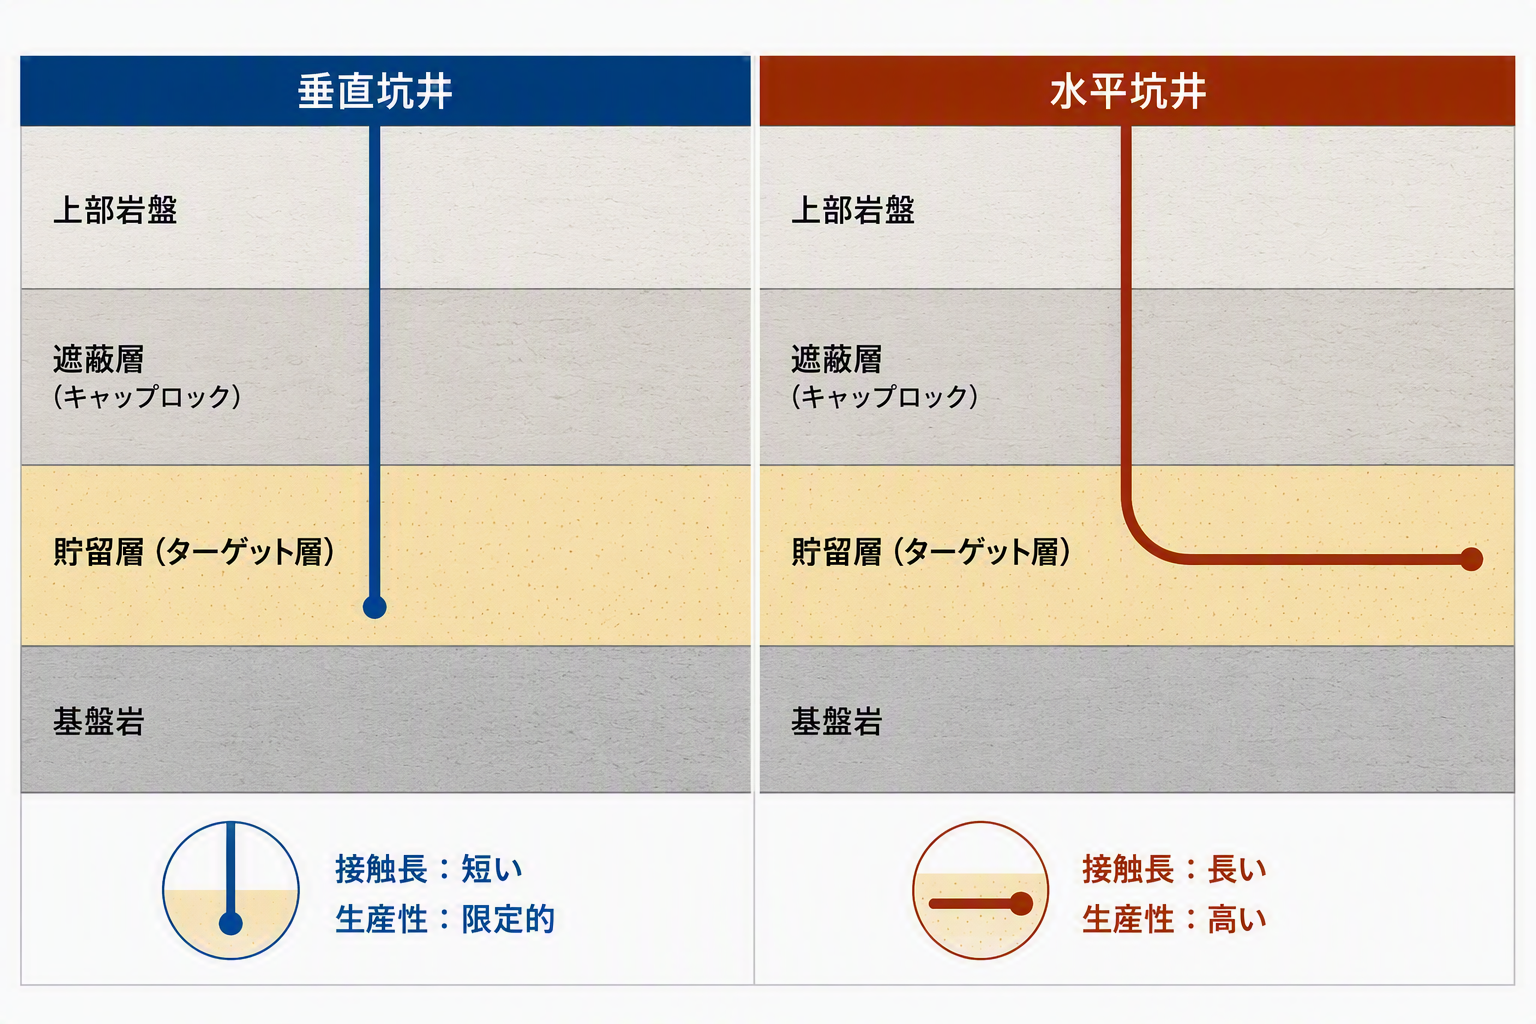 図1. 垂直掘削と水平掘削の違い
True Vertical Thickness (TVT)
TVTとは、地層の上面(基準面)から坑井のビット位置までを垂直方向に測った距離のことを指します。深さZが同じでも、地層が傾いていればTVTは変化します。TVTは、幾何学的な深さではなく、地層のどこを掘っているかを表す指標です。水平掘削においては、炭化水素を含む貯留層との接触面積を最大化するため、地層の傾きに追従して貯留層内の狙った位置(TVT)を保ちながら掘り進めることが重要です。掘削を進めながら、リアルタイムで地層の傾きにあわせて方向を補正することを、ジオステアリングと呼びます。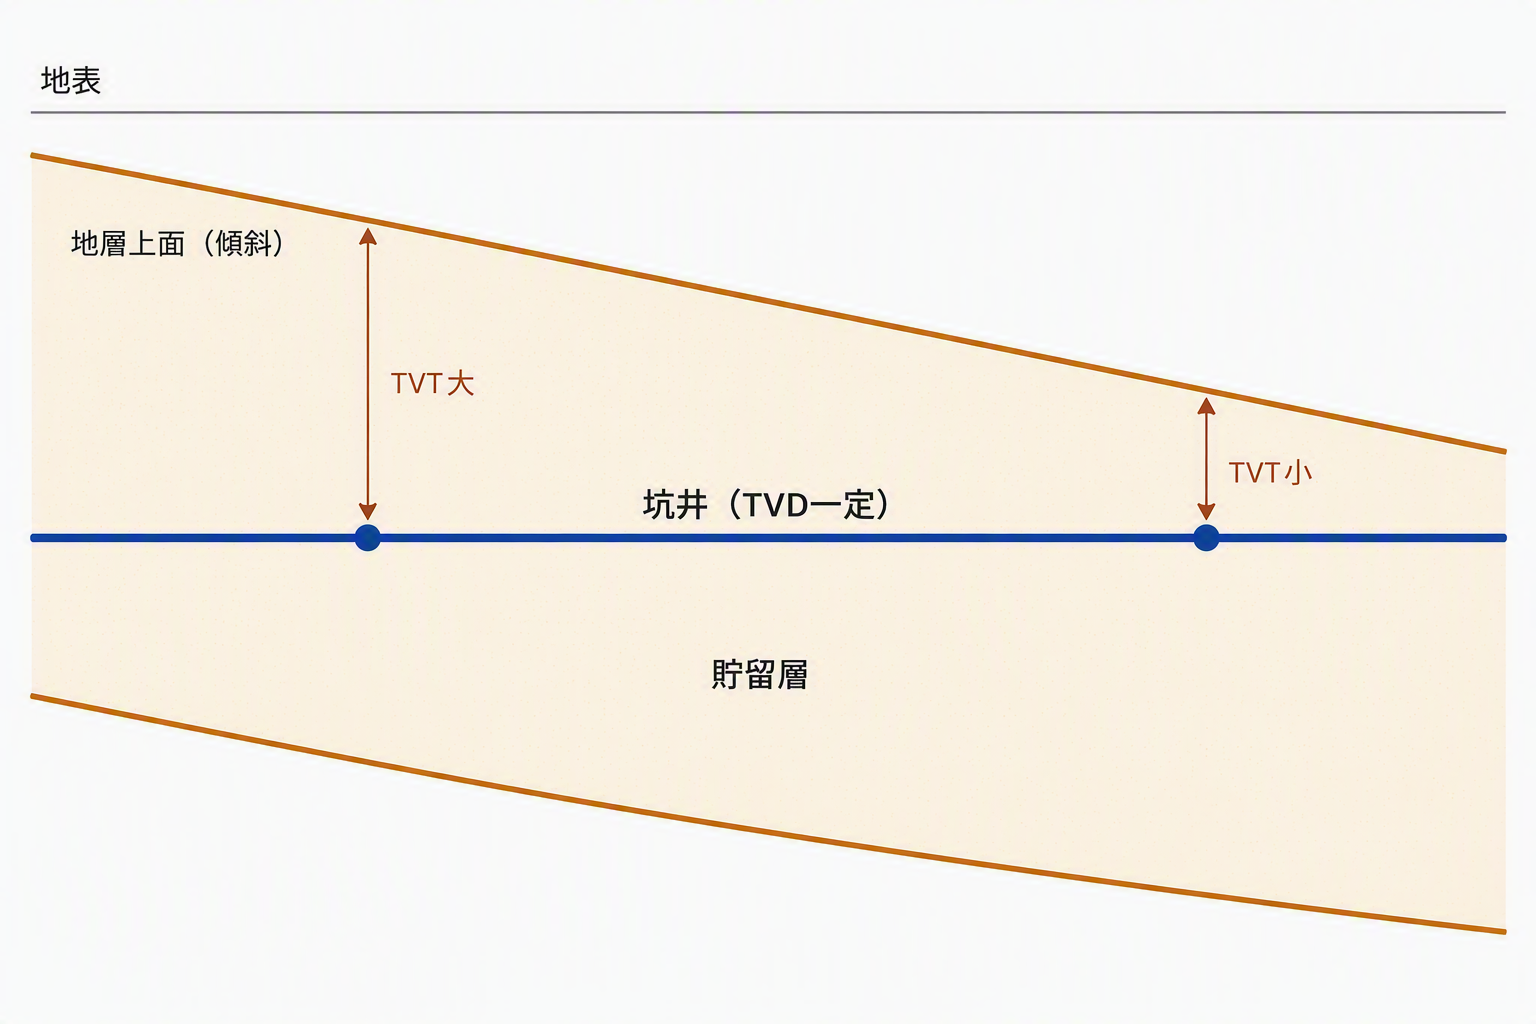
図2. 地層の傾きによるTVT変化イメージ
提供されたデータ
本コンペでは、以下のデータを使用しました。学習データが773坑井分、テストデータは約200坑井分となっています。
- {WELLNAME}_horizontal_well.csv
- 井戸ごとの水平掘削の軌道及びログデータが格納されたもの。各行に対して以下のデータが存在。
- MD: measured depth。地表からの掘削長。
- X, Y: ある点を基準点とした、水平面上の座標。
- Z: 海水面を基準とした、絶対深さ。
- Geology:ANCC, ASTNU, ASTNL, EGFDU, EGFDL, BUDAのいずれか。学習データにのみ存在。
- TVT: True Vertical Thickness。今回の予測対象である、地層の上面(基準面)から坑井のビット位置までを垂直方向に測った距離。学習データにのみ存在。
- GR: Gamma Ray (API)。各点における、地層(岩相)から自然放出されるガンマ線強度の記録。
- TVT_input:TVTのうち、事前に与えられるデータ。井戸ごとにばらつきはあるものの、垂直掘削から水平掘削へと推移する領域付近まで与えられるケースが多い。評価対象区間がNaNになっている。
- 井戸ごとの水平掘削の軌道及びログデータが格納されたもの。各行に対して以下のデータが存在。
- {WELLNAME}_typewell.csv
- 各井戸に対して、参照となる垂直掘削時のデータ。各行に対して以下のデータが存在。
- TVT: True Vertical Thickness。地層の上面(基準面)から測った垂直距離。参照とするデータであるので、学習データとテストデータの双方で存在。
- GR: Gamma Ray (API)。各TVT位置における基準ガンマ線プロファイル。
- Geology:ANCC, ASTNU, ASTNL, EGFDU, EGFDL, BUDAのいずれか。学習データにのみ存在。
- 各井戸に対して、参照となる垂直掘削時のデータ。各行に対して以下のデータが存在。
したがって、ざっくりとコンペのタスクを説明すると以下のようになります。
- TVTに対するガンマ線強度のリファレンス、掘削時の各種ログデータ、掘削途中までのTVT真値が与えられる。
- これらを参考に、未知区間のTVTを予測せよ。
評価指標
本コンペの評価指標は、二乗平均平方根誤差(RMSE)です。テストデータの全行をまとめて、予測値と真値の誤差から計算されます。
テストデータの行数を n、各行 i における TVT の予測値を ŷᵢ、真値を yᵢ として、
RMSE = √( (1/n) × Σ[i=1〜n] (ŷᵢ − yᵢ)² ) ※元記事はLaTeX数式表示のため、体裁は要確認
と定義されます。値が小さいほど予測精度が高く、良いスコアであることを意味します。単位は TVT と同じフィート(ft)です。
提出ファイルは、テストデータの各行に対して予測した tvt を、id,tvt の形式で1行ずつ記載したものです。id は坑井名と行番号を組み合わせたもの(例:000d7d20_1442)になります。
コンペへの取り組み方
本コンペでは、水平坑井におけるTVT予測という、自分にとっては馴染みのない分野を扱っていました。そこでまずは水平掘削の一般的な知識をインプットするところから始めました。
- 水平掘削及びジオステアリング全般についてのインプット
- Kaggle Discussionを確認すると、コンペ主催者からまとまった情報が提供されていたので、一通り確認しました。[3] 特に、ジオステアリングの解説をした動画は、タスクのイメージを掴むのに非常に役立ちました。
- 提供されているデータの確認
- 提供されているデータについて、それぞれのカラムごとの特徴を確認しました。例えば
- ガンマ線の測定結果には比較的大きなノイズが乗っていること
- X, Yは基準点からの相対座標であるが、すべての坑井において同じ基準点が使われており、空間的な関係性を把握することは可能であること
- TVTの変動幅は坑井によって大きく差があり、かつ、TVTがフラットな坑井が多いこと
- 提供されているデータについて、それぞれのカラムごとの特徴を確認しました。例えば
- 公開ノートブックの解法の確認
- Particle FilterやBeam Searchを使用した解法が多く公開されていました。いずれも、GRやZの変化を基に、TVTの変化を掘削方向に沿って予測する手法です。これはジオステアリングとほぼ同様で、現在地までで得られた情報を基にTVTを推測する手法であるとも言えます。まずはそれらをローカルで回し、どの程度のスコアが得られるのか・どのような解が出力されるのかを確認することにしました。(これらは学習無しで推論する方法なので、クロスバリデーション等を気にしなくても学習データに対するスコアを得ることができます。)
- 出力された解を可視化して確認すると、性能の差が大きいことがわかりました。現在地までの整合性を取ることが優先される手法であるため、MDが大きくなるにつれて徐々に誤差が累積し、スコアが悪化していることが確認されました。
これらの確認結果を踏まえ、従来のジオステアリング的な逐次予測方式ではなく、「未来の情報も踏まえた、全体整合を取ることが可能な予測手法」の方が良いスコアが得られるのではないかと考えました。また、ローカルでの評価結果はRMSEが10ft超であるのに対し、public LBでは8ft程度となっていました。テストデータ約200坑井のうち25%程度が public LB に反映される仕様であり、public LBのスコアがテスト全体のスコアを代表しているとは限りません。この時点から、public LB の数字に振り回されず、信頼できるクロスバリデーションを設計し、その CV スコアを判断の軸に据えることが重要だと考えました。
解法概要
アーキテクチャ
前節で述べた「全体整合を取る予測手法」という方針から、予測対象とする点の前後の文脈を広くモデルに投入できる、ニューラルネットワーク系の手法が良いと考えました。最終的には、水平坑井のGR系列を1次元系列として扱い、typewell(参照井)のGRプロファイルと照合してTVTを推定するアーキテクチャとしました。
まず、水平坑井側の観測系列(正規化したGR、正規化GRを平滑化したもの、掘進に伴う深度勾配 dZ/dMD、アンカーからの相対深度、掘進方位)を dilated 1D-CNN でエンコードします。dilated畳み込みを重ねることで、局所的なGRの形状から数百〜数千ステップにわたる広い文脈までを一度に捉えることを企図しています。
一方、typewell側は「TVT軸上のGRプロファイル」をグリッドとしてエンコードします。この2つを cross-attention で結び、水平坑井の各点が「typewellのどのTVT位置に対応するか」という確率分布(アラインメント分布)を出力します。今どの層を掘り進めているのか?を、GR形状の照合として解くようなイメージになります。DTW系の手法の考え方からも着想を得ました。
得られた分布は、地層の連続性を反映するために particle-filter型の処理を行いMD方向に平滑化します。最後に 期待値デコード(分布とTVTグリッドの重み付き和)で1つのTVT値とし、出力します。
最後に、学習済みモデルの重みは固定したまま、出力されたTVT曲線を「その曲線でtypewell GRをサンプルした波形(rendered GR)が、実測GRに一致する」ように直接最適化する後処理を入れました。GR照合の整合性を出力レベルで詰めることで、平均してpooled RMSEにおいて0.1 ~ 0.3ftの改善が見られました。
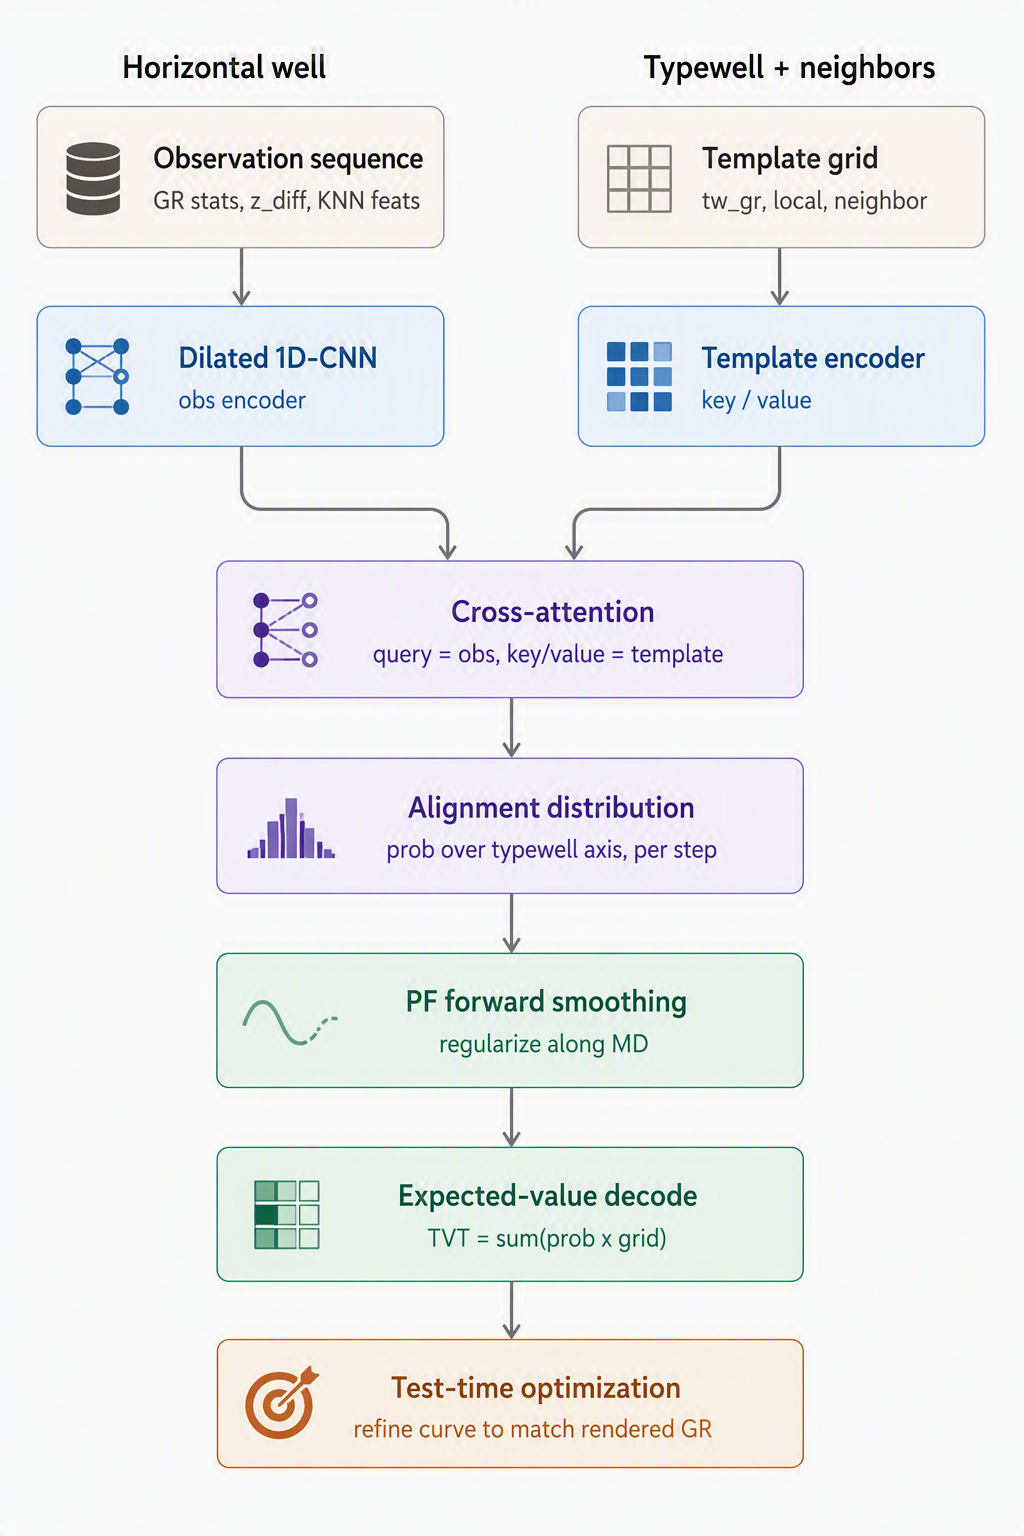 図3. モデルのアーキテクチャ
結果的に、この畳み込みベースのアークテクチャの採用が効果的で、この段階で最終銀メダル相当のスコアを獲得することができていました。(後述の表1を参照)
学習
学習は、正解位置を中心に平滑化した確率分布を教師とするクロスエントロピーを主損失としました。補助ロスとして、平滑性・エントロピーの補助項を加えました。
また、学習データを充実させることで性能を向上できると考え、データ拡張を試みました。比較的初期に試した「系列を反転させるaugmentation」(現実とは逆方向に掘り進めているとして、GRやTVTなどをすべて反転させる)は、CV、LBとも0.4 ~ 0.5程度改善する効果がありました。このaugmentationは基本的にすべてのモデルの学習に取り入れています。
他にもいくつかのAugumentationを試しましたがあまり効果は得られませんでした。合成の度合が強すぎたことで、実データとの傾向乖離が大きくなってしまったことが原因ではないかと考えます。実際、上位解法を見ると、自分が取り入れた系列反転以外にもさまざまなaugmentationを取り入れた学習を成功させていました。コードレベルで上位陣の解法を確認し、次回のコンペに活かせる知見を取り入れていきたいです。
クロスバリデーション
クロスバリデーションの構成は、773坑井を空間的に層化した5分割としました。これは、事前の情報として、以下の情報が分かっていたためです。
- train とtest 井戸は同じエリアに存在しており、かつ、それらをランダムに分割したものであると考えられること
- 空間的に近い井戸どうしは、同じような地層構造を示す傾向にあること
これらの情報に基づき、単に坑井をランダム分割するのではなく、X・Y座標に基づく空間グループで層化することで、「近傍の坑井が学習側と検証側に漏れ合う」ことによるデータリークを抑えることを狙いました。評価は公式指標通り、全評価点をまとめた pooled RMSE(行数で重み付け)で計算しました。
モデルアンサンブル・提出
単一モデルの精度には限界があるため、複数モデルのアンサンブルを行いました。ここで、個々のモデルを強くするだけでなく、モデル間の誤差相関を下げることを狙ってモデルの構築を行いました。具体的には以下のようなモデルを構築し、アンサンブルの部材としました。
- 構築初期のパラメータで学習したモデル。モデル単体でのCV 8.65ft, Public LB 7.02 ft。
- 構築初期のパラメータからいくつかを変更し、正則化を加えたモデル。
- TVTグリッドの解像度(ビン数)を256から512に上げたモデル。より細かいTVT構造を照合することが出来る。
- 学習時に入力する系列長を2048から1024へ短くしたモデル。
入力系列を短くすると、局所的なGR照合に強く難しい坑井で有利になる一方、長い系列の場合、学習したモデルは緩やかなトレンドの把握に強く易しい坑井で有利になる傾向があります。両者は互いに補完的であり、ブレンドで組み合わせることで双方の強みを取り込めました。
CV・Public LB・Private LB の比較と結果
最終的な提出候補について、CV・public LB・private LB を比較すると次のようになります。
表1. 提出したモデルの構成とスコアの比較
| 構成 | CV | Public LB | Private LB | 提出 |
| model1 | 8.65 | 7.02 | 8.03 | |
| model1 + model2 + model3 | 7.192 | 6.249 | 7.703 | 〇 |
| model1 + model2 + model3 + model4 | 6.973 | 6.427 | 7.383 | 〇 |
CV上は4モデルブレンドの方が良いスコアでしたが、public LB では3モデルブレンドの方が良いスコアを示していました。これは、public LBに反映される坑井が全体の分布を反映しておらず、やや予測が簡単(自分のモデルにとって)な井戸を多く含むからではないかと考えました。したがって、public LBを過信せず、CVのスコアを信じて提出するモデルを決めました。結果としては4モデルブレンドの方がprivateではスコアが良く、かつ、自身の提出の中でも最良スコアとなっていました。
まとめ
本記事では『ROGII - Wellbore Geology Prediction』のコンペ概要やタスク、解法について紹介しました。データを注意深く観察して適切な手法を選択、CVスコアを参考にしながらモデルを改善することで銀メダルを獲得することができました。また、今後のコンペにも活かせる知見・経験も、多く得られました。
今後も各種コンペに参加するにあたっては生成AIを活用することになると思いますが、人間の労力が必要なところを惜しまず、双方の得意な領域をブレンドしてスコアを最大化することを忘れずに取り組んでいきたいと考えています!
ARISE analyticsでは、コンペ参加などを通じた自己研鑽も積極的に奨励されています。他コンペへの参加記やKaggle部など社内勉強会の紹介も公開されていますので、興味のある方はぜひご一読ください。
https://www.ariseanalytics.com/tech-info/20260409
https://www.ariseanalytics.com/tech-info/20250822
参考
[1] https://journal.jogmec.go.jp/oilgas/termsearch/list/su/horizontal-drilling.html
[2] https://www.enecho.meti.go.jp/about/whitepaper/2015html/1-1-1.html
[3] https://www.kaggle.com/competitions/rogii-wellbore-geology-prediction/discussion/697416