

「やさしい日本語」らしさをどう評価するか?ー既存研究における「やさしい日本語」評価の指標ー
 SNSシェア


いいね
こんにちは。AIエンジニアの岡部とデータコンサルタントの齋藤です。
本記事では、私たちが会社をより良くするために社員有志が活動するWG(ワーキンググループ)として取り組んでいる「やさしい日本語言い換えプロジェクト」の一環として、やさしい日本語が日本語学や自然言語処理分野においてどのような評価設計を有しているかに関する調査結果を報告します。
この記事でわかること
- 日本語学・自然言語処理分野における「やさしい日本語」評価指標の全体像
- 既存指標が「やさしい日本語」に使いにくい理由
本プロジェクトの概要
最初に「やさしい日本語言い換えプロジェクト」の概要について簡単に説明させてください。
本プロジェクトは、日本で日本語を学習・使用している非母語話者を対象とし、彼らが日々仕事をするなかで遭遇する日本語表現をLLMによって「やさしい日本語」に言い換えることで、ビジネス遂行をスムーズにするツールの構築を目指すものです。
在留外国人は年々増加傾向にあり、令和7年末には400万人を超えました(出入国在留管理庁, 2026)。在留外国人の増加傾向に伴い、外国人労働者も過去最多の257万人に達しています(厚生労働省, 2026)。一方で、外国人を雇用する企業や外国人と一緒に働く日本人会社員側からは、「日本語能力のためにコミュニケーションが取りにくい」といった意思疎通の困難さが課題として挙げられています(厚生労働省, 2023; ワークスモバイルジャパン株式会社, 2023)。
こういった、日本語を母語としない方とうまくコミュニケーションをとるための、非母語話者にもわかりやすい日本語として注目されているのが「やさしい日本語」です。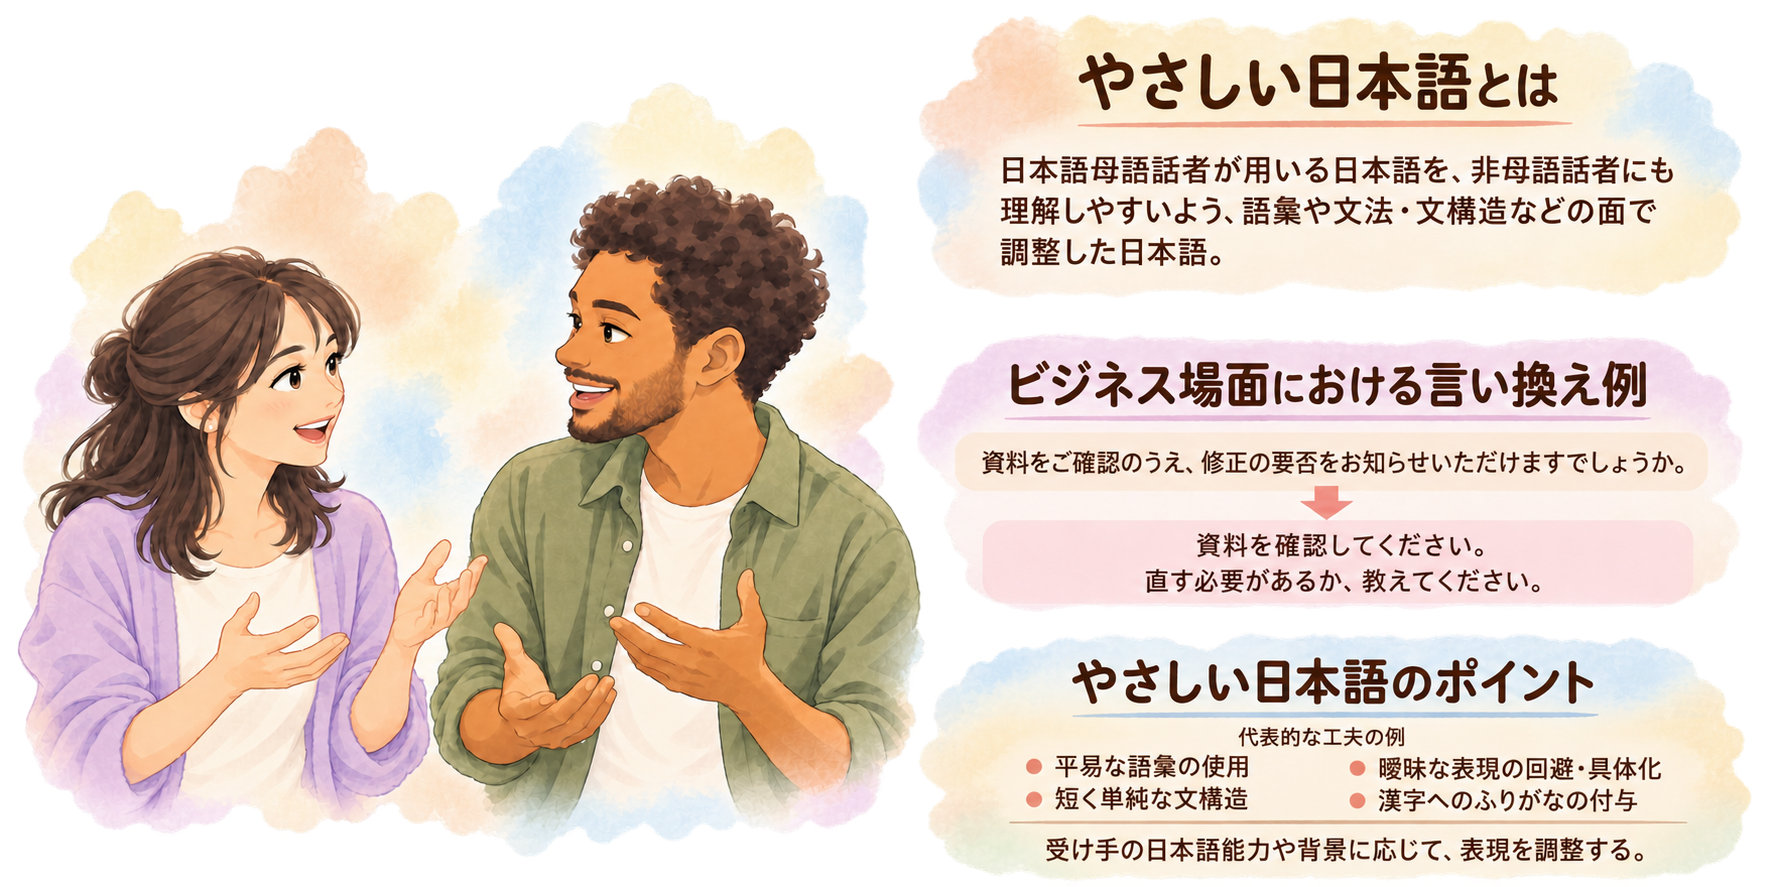
日本語母語話者側が、言いたいこと、伝えたいことを「やさしい日本語」に言い換えることで、ビジネスシーンにおける日本人-外国人間のコミュニケーションを円滑に遂行することを支援し、より効率よく、より大きなビジネス価値生み出すことができるようになるのではないか。これが本プロジェクトが目指す姿です。
こういった言い換えツールを作ることを考えるとき、元の日本語がどういった日本語になっていれば「やさしい日本語」として適格であるかを定義し評価する仕組みが必要になります。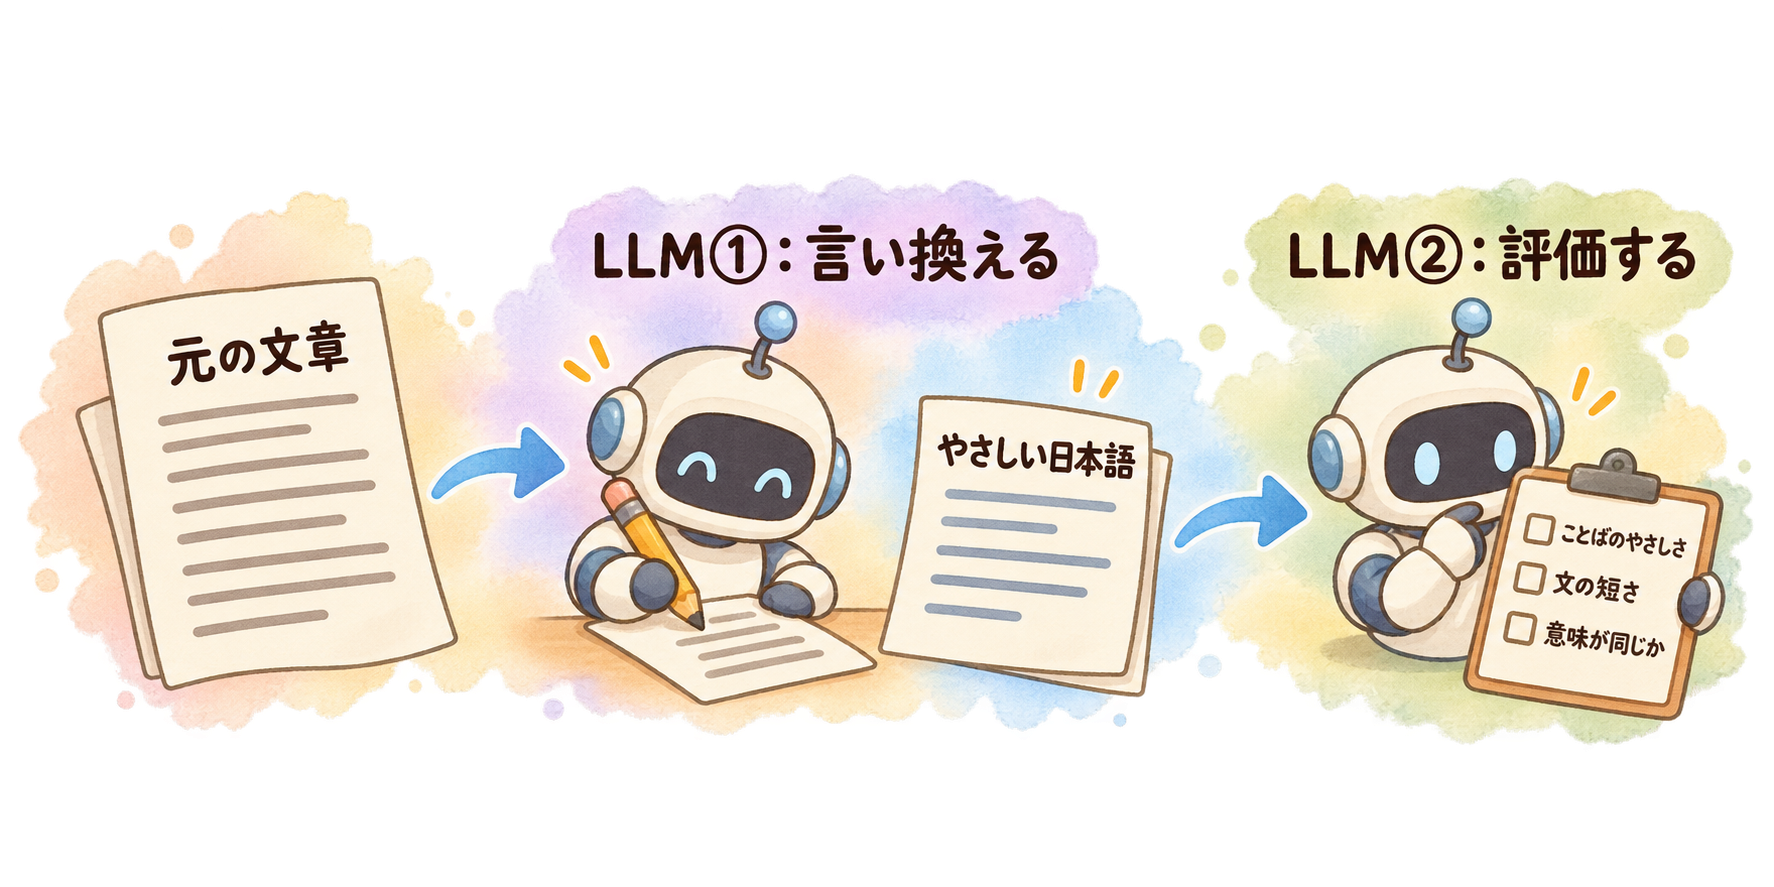
以下では、「やさしい日本語」らしさの評価に関する言語学、及び自然言語処理の既存研究内容について整理し、現状の課題を論じます。
日本語学における「やさしい日本語」 ― 既存研究の概観
「やさしい日本語」の成り立ちと広まり
評価の話をする前に、そもそも「やさしい日本語」はどのような経緯で生まれたのでしょうか。
「やさしい日本語」は、当初、1995年の阪神・淡路大震災をきっかけとして、災害場面における外国人への情報提供の問題にアプローチするために、社会言語学者佐藤和之氏を中心としたチームによって発案され、普及促進されてきました(吉開, 2020ほか)。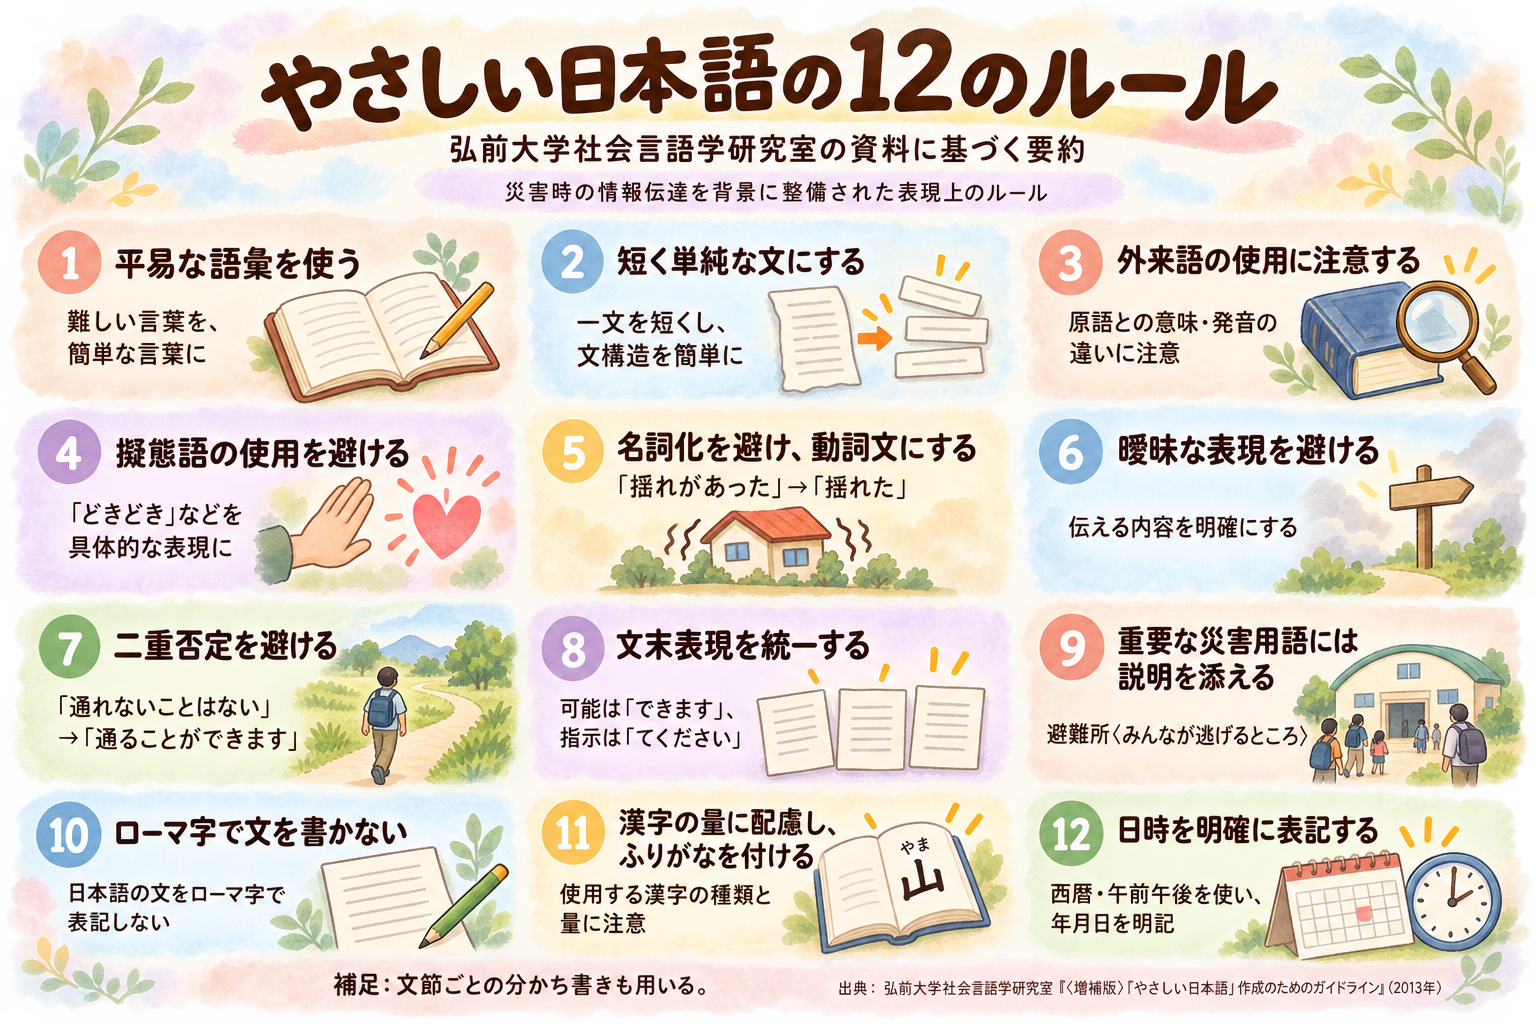
その後、日本語学者庵功雄氏らのチームが、災害場面にとどまらず平時のコミュニケーションでも有効な<やさしい日本語>を定義し、自治体での導入支援等を行ってきました※1(庵, 2016ほか)。近年では、様々な地方自治体で「やさしい日本語」のガイドラインの作成や職員研修が進んでいるほか(出入国在留管理庁・文化庁, 2020)、2019年には出入国在留管理庁から『生活・就労ガイドブック』のやさしい日本語版『生活・仕事ガイドブック』が公開され、各省庁でも「やさしい日本語」を活用した取り組みが進められるようになってきています。
「やさしい日本語」の活用における課題
こういった取り組みが進む一方で、実際に行政等の現場で日本語を「やさしい日本語」に言い換える際の問題点として、① 表現や漢字が日本語学習者にとってどれぐらい難しいのかが分からないため、書き換えすべき箇所を特定することが困難であること、② 書き換えすべき箇所をどのように書き換えるべきかが分からないことがあるとも指摘されています(庵功雄・イヨンスク・森篤嗣 (編), 2013)。例えば、やさしい日本語の基準の一つとして「語彙を日本語能力試験3級・4級レベル程度までに限定すること」という特徴がありますが、日本語教育等に関する専門教育を受けていなければ、どういった単語がこの条件に当てはまる、あるいは当てはまらないのかは、判断がつかないものだと思います。また、単語や表現、そして表記を書き換えたとして、③ 言い換えた結果の「やさしい日本語」文が、総体として、本当に非母語話者にとって「やさしい」かが母語話者にはわからないことも、日本語母語話者にとって、言い換え作業を難しくする要因の一つとなりうることは想像に難くありません。
「やさしい日本語」への言い換えツールと「やさしい日本語」らしさの評価
そこで、日本語教育に関する経験や知見がなくても、適切に「やさしい日本語」に言い換えできるよう支援するツールが、言語学領域からさまざま提供されています。
「表現が非母語話者にとってどれぐらい難しいか分からない」という課題に対する代表的なツールとしては、入力された文に含まれる語彙の難易度をもとにアラートを表示する「やんしす」があります。後者の「どのように言い換えるべきか分からない」という課題については、例えば、前述の庵氏のチームによる、「公文書作成支援システム」の開発・提供が行われています。このシステムでは、日本語教師によってやさしく言い換えられた表現をベースに公文書の日本語を「やさしい日本語」に置き換えます。
また、本記事の主眼である「言い換えられた『やさしい日本語』文が本当に『やさしい日本語』になっているか」の評価に利用できるツールとしては、語彙の難易度をもとに入力文の難易度判定を行う「リーディング・チュウ太」や「やさにちチェッカー」があります。「やさにちチェッカー」は公用文の難易度判定を主眼とし、入力文を語彙・漢字・硬さ・長さ・文法の5指標で評価したうえで、総合判定を表示してくれます。
このように、日本語学においては、日本語学者、日本語教師といった専門家依拠の判断基準のほか、特に文中の語句に着目した、定量的な評価指標をもとに文の「やさしい日本語」らしさを評価する試みがなされています。
一方で、例えば、漢字を含む語が難しいかどうかは、非母語話者側の母語に漢字が含まれるかどうかに依存するなど(Nohejl et al., 2024)、読み手による「やさしい日本語らしさ」の違いは既存評価指標ではカバーしきれていない部分です。また、複雑な語彙や文法事項をただ置き換えていくだけでは、最終的に文や文書全体が「やさしい日本語」になるとは限りません。もとの日本語文にそもそも冗長で回りくどい表現が含まれていないか等の観点から、情報が伝わりやすいように情報の取捨選択や再構築を行うことで、日本語文をやさしく言い換える必要があることも指摘されています。
| 粒度 | 定量的な指標 | 定性的な評価 | 主な課題 |
| 語彙 | リーディング・チュウ太(語彙チェッカー) | 専門家判断 | 評価者・読み手による「やさしい日本語らしさ」の違い |
| 文 | やさ日チェッカー(語彙・漢字・硬さ・長さ・文法の5指標で評価) | 専門家判断 | 評価者・読み手による「やさしい日本語らしさ」の違い |
| 文書 | ー | 専門家判断 | 語彙・文の難易度と文書全体の難易度が紐づいていない |
自然言語処理と「やさしい日本語」 ― 既存研究の概観
ここまで見てきたように、日本語学の領域では、専門家の知見に基づく判断と、語彙・文を単位とした定量的なツールの両面から「やさしい日本語」らしさが評価されてきました。一方で、近年はLLMに「やさしい日本語」への言い換えを行わせる研究も始まりつつあり(李・長谷部, 2025)、その背景には「テキスト平易化」という分野があります。そこで、自然言語処理におけるテキスト平易化評価の考え方の整理を試みます。
テキスト平易化(Text Simplification)
「やさしい日本語」への言い換えは、文章の意味をできるだけ保ったまま語彙や構文の複雑さを減らし、文章が読みやすくなるよう同じ言語を用いて書き換えるタスクです。これは自然言語処理においてテキスト平易化(Text Simplification)とよばれる分野に対応します。
テキスト平易化の研究は、日本語学の流れと同じように語彙・文・文書の粒度に大別することができます。
例えば、語彙の粒度では、語がどれだけ難しいかを推定する語彙難易度推定の研究があります。英語を含む10言語を対象としたMultiLS(Shardlow et al., 2024)は、実際の文脈に現れる語ごとに、難しさの度合いと、より平易な言い換え候補をあわせて付与したデータセットです。語の難しさの推定と言い換えの両方を、同じデータで評価できるように設計されています。その日本語版にあたるMultiLS-Japanese(Nohejl et al., 2025)もあり、日本語の非母語話者を読み手として想定して構築されています。
文の粒度では、人間が作成した参照文と比べて編集操作(追加・削除・保持)の適切さを測るSARI(Xu et al., 2016)、平易化の総合的な品質に対する人手評価で学習したLENS(Maddela et al., 2023)、参照文を使わずに平易さのみを推定するSLE(Cripwell et al., 2023)などの評価指標が提案されています。
語彙・文の粒度と比べると文書の粒度の研究は限られますが、SARIを文書の粒度に拡張したD-SARI(Sun et al., 2021)が提案されているほか、意味保持の評価には、QuestEval(Scialom et al., 2021)のように本来は要約の事実整合性を評価するために提案された指標が転用されることもあります。また、Maddela & Alva-Manchego(2025)では、文の粒度の平易化指標を文書の粒度に適用する方法も検討されています。
このように、テキスト平易化分野では研究の蓄積がある一方、「やさしい日本語」に必要な文・文書の平易化の視点で見ると限界もあります。
まず、文・文書の粒度のテキスト平易化では、SLEのような「読みやすいかどうか」(平易さ)と、QuestEvalのような「意味を保持しているか」(意味保持)の2軸が存在します。平易さを高めるために大胆に編集すれば意味が失われ、意味を保持するために編集を控えると平易にならないため、これらの2軸は相反的な関係にありますが(廣中 et al., 2022; Cripwell et al., 2024)、既存の平易度指標の多くが2軸をまぜこぜにして1つの指標で評価しています。
くわえて、文書の粒度では、単に平易かどうか・意味を保持しているかどうかのみならず、段落・文書全体で筋が通っているか(談話的一貫性)、コンテクストを踏まえて意図が伝わるか(語用論的適切さ)、文書全体の情報がすらすらと頭に入ってくるか(認知負荷)といった観点が指摘されています(Yamashita et al., 2026)。英語では、Wikipediaの編集履歴から談話レベルの再構成を含む平易化操作を復元したSWiPE(Laban et al., 2023)や、平易化結果の一貫性の評価を扱ったVásquez-Rodríguez et al.(2023)などの研究がありますが、これらの観点を体系的に評価する指標が確立されているとは言いがたい状況です。
「やさしい日本語」への応用における課題
上では、限界はありつつも、語彙・文・文書の各粒度で平易化の指標が整備されていることを示しました。これらの指標を日本語に適用すれば、日本語から「やさしい日本語」への言いかえ評価や適切な言い換え作成は簡単にできそうにみえます。
しかしながら、「やさしい日本語」に適用するのは容易ではありません。指標作成時の学習元となる、文書レベルの難文・易文パラレルコーパスが限られているためです。
実際、日本語では、SNOW(Maruyama & Yamamoto, 2018; Katsuta & Yamamoto, 2018)、JADES(Hayakawa et al., 2022)、MATCHA(宮田 et al., 2024)といった文レベルのパラレルコーパスは整備されていますが、文書レベルのパラレルコーパスは、Wikipediaおよび毎日新聞を基にしたJADOS(Nagai et al., 2024)など、依然として整備途中の段階です。しかも、コーパスがあったとしても、日本語においては既存の指標が有用ではない可能性もあります。Nagai et al.(2024)やYamashita et al. (2026) は、JADOSを基にD-SARIと人手評価を比較し、両者の相関が弱いことを報告しています。
データセットに頼らない方法:LLM-as-a-judgeという選択肢
では、学習データセットに依存しない研究はないのでしょうか?「やさしい日本語」への言い換えは遠い道のりなのでしょうか?
有力な方法として、データセットに依存する定量指標を用いるのではなく、平易化の観点に沿っているかを定性的に検証する考え方があります。Yamashita et al. (2026) では、Cripwell et al. (2024)をもとに平易化の4観点(必要性・十分性・文の平易度・文書の平易度)を定め、プロンプトベースのLLM-as-a-judgeによって評価させる方法を検討しています。一見シンプルな方法ですが、結果が一定程度モデルに依存するとはいえ、GPT-4oやGemini 2.5 Proでは例を与えない設定(0-shot)でも人手評価との一致率がおおむね7〜8割に達することが報告されています。
ただし、「やさしい日本語」への言い換えという視点では、Yamashita et al. (2026)にも限界があります。この論文では、文・文書の平易度を小学6年生程度の読解レベルを基準として評価しています。一方、母語話者が感じる難しさと非母語話者が感じる難しさは異なる可能性があるため、「やさしい日本語」に応用するためには、非母語話者を基準とした評価基準を別に定める必要があるでしょう。また、非母語話者の間でも母語によって感じる難しさは異なることが示唆されており(Nohejl et al., 2024)、これも評価基準の検討項目となります。
まとめると、定量的な評価指標を「やさしい日本語」に適用するのはデータセットの観点でハードルが高いと考えられます。定性的に「やさしい日本語」の評価観点を定めたうえで、素直にLLM-as-a-judgeの力を借りて平易度を評価することが、「やさしい日本語」への言い換え精度を高める近道かもしれません。
先行研究のまとめ:各分野における代表的な既存指標の整理
上述の調査内容を踏まえ、既存の評価の現状を定量・定性の二軸で整理したのが下記の表です。
| 定量(自動算出) | 定性(観点に沿った判断) | |
| 日本語学 | リーディング・チュウ太、やさ日チェッカー 等(主に語彙・文) | 専門家判断 |
| 自然言語処理 | SARI、D-SARI、LENS 等(文書は発展途上) | 人手評価の各軸、LLM-as-a-judge(文〜文書) |
今回の調査の結果、日本語学、自然言語処理の両分野において、語彙・文レベルでは定量的な評価が一定確立されていることが分かりました。また、定性的な観点からは、専門家等の人目で判断するのがこれまでの主流でしたが、昨今の生成AI技術の興隆により、LLMに判断させるという手法も、特に自然言語処理分野で試行されています。一方で、文書レベルの評価については、定量・定性的な観点のいずれの面でも評価軸自体がまだ十分に整理されていない状況と言うことができると思います。
現状の課題と今後の展望
本プロジェクトで構想するような「LLMで言い換え、その結果をLLMで評価する」仕組みに照らして考えたとき、現状の両分野の既存研究を参照するだけでは、LLM側にインプットすべき「やさしい日本語らしさ」の評価軸が必ずしも適切に設定できない可能性がある状態であるということができると思います。
こういった課題に対して、特に文書レベルにおける「やさしい日本語」らしさの評価軸の精緻化に取り組むことを考えてみてもいいのではないでしょうか。
アプローチとしては、例えば、評価軸自体もLLMに作らせることにして、LLMが規則を帰納できるようなデータセットを渡してルール抽出してもらうというのは一つの案として考えられます。しかし、「自然言語処理と『やさしい日本語』 ― 既存研究の概観」節で見たように、我々が作りたいツールに適したデータセットが整備されているわけではないというのが現状です。あるいは、既存の軸をベースにしながら、言い換え操作をもとに評価軸を精緻化していくというのも一つ可能な選択肢として考えられるでしょう。
「やさしい日本語らしさ」をどのように評価していくべきかという問いに我々なりの答えを見出すことで、プロジェクトが目指す「ビジネスシーンにおける日本人-外国人間のコミュニケーションの円滑化」をより良いかたちで実現していけるよう、今後も調査・開発を進めていきたいと思います!
註
※1:なお、佐藤氏の提唱する「やさしい日本語」と庵氏の提唱する<やさしい日本語>は、上記のように表記を分けるケースがあるが、 本記事においては区別しない。
参考文献
日本語文献
庵功雄 (2016). やさしい日本語―多文化共生社会へ (岩波新書). 岩波書店.
庵功雄 (編) (2022). 「日本人の日本語」を考える―プレイン・ランゲージをめぐって. 丸善出版.
庵功雄・イヨンスク・森篤嗣 (編) (2013). 「やさしい日本語」は何を目指すか―多文化共生社会を実現するために. ココ出版.
庵功雄・岩田一成・佐藤琢三・柳田直美 (編) (2019). 〈やさしい日本語〉と多文化共生 (学習院女子大学グローバルスタディーズ5). ココ出版.
庵功雄・岩田一成・森篤嗣 (2011). 「やさしい日本語」を用いた公文書の書き換え―多文化共生と日本語教育文法の接点を求めて. 人文・自然研究, 5, 115–139. https://doi.org/10.15057/19016
岩田一成 (2020). 文章の難易度測定方法に関する研究―「やさにちチェッカー」の「硬さ」について. 京都語文, 28, 23–37.
岩田一成 (2024). やさしい日本語ってなんだろう (ちくまプリマー新書). 筑摩書房.
吉開章 (2020). 入門・やさしい日本語―外国人と日本語で話そう (増補版). アスク.
厚生労働省 (2026). 「外国人雇用状況」の届出状況まとめ(令和7年10月末時点). https://www.mhlw.go.jp/stf/newpage_68794.html
厚生労働省 (2023). 令和5年外国人雇用実態調査. https://www.mhlw.go.jp/stf/newpage_46975.html
出入国在留管理庁 (2023). 令和4年度在留外国人に対する基礎調査報告書. https://www.moj.go.jp/isa/content/001402047.pdf
出入国在留管理庁 (2024). 生活・仕事ガイドブック (やさしい日本語版, 第6版). https://www.moj.go.jp/isa/guidebook_all.html
出入国在留管理庁 (2026). 令和7年末現在における在留外国人数について. https://www.moj.go.jp/isa/publications/press/13_00062.html
出入国在留管理庁・文化庁 (2020). 在留支援のためのやさしい日本語ガイドライン. https://www.moj.go.jp/isa/content/930006072.pdf
田中日加吏・Chen Zhousi・Bian Kexin・小町守 (2025). 文書レベルの日本語平易化の評価基準の提案とデータセット構築. NLP2025ワークショップ:LLM時代のことばの評価の現在と未来.
廣中勇希・井川朋樹・梶原智之・二宮崇 (2022). QENTS:テキスト平易化の品質推定のためのデータセット. 言語処理学会第28回年次大会発表論文集 (pp. 516–520).
文化庁 (2001). 日本語に対する在住外国人の意識に関する実態調査. https://www.bunka.go.jp/tokei_hakusho_shuppan/tokeichosa/nihongokyoiku_jittai/zaiju_gaikokujin.html
宮田莉奈・惟高日向・山内洋輝・柳本大輝・梶原智之・二宮崇・西脇靖紘 (2024). MATCHA:専門家が平易化した記事を用いたやさしい日本語パラレルコーパス. 自然言語処理, 31(2), 590–609. https://doi.org/10.5715/jnlp.31.590
李在鎬・長谷部陽一郎 (2025). ChatGPTによる日本語ニュースの平易化―生成AIと「やさしい日本語」. 計量国語学, 34(8), 563–573.
ワークスモバイルジャパン株式会社 (2023). 【外国人労働者とのコミュニケーション実態に関する調査】一緒に働いたことがある会社員の55%が「意思疎通が十分でない」と回答. https://line-works.com/pr/20230530/
英語文献
Cripwell, L., Legrand, J., & Gardent, C. (2023). Simplicity level estimate (SLE): A learned reference-less metric for sentence simplification. In Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing (pp. 12053–12059). Association for Computational Linguistics. https://doi.org/10.18653/v1/2023.emnlp-main.739
Cripwell, L., Legrand, J., & Gardent, C. (2024). Evaluating document simplification: On the importance of separately assessing simplicity and meaning preservation. In Proceedings of the 3rd Workshop on Tools and Resources for People with REAding DIfficulties (READI) @ LREC-COLING 2024 (pp. 1–14). ELRA and ICCL. https://aclanthology.org/2024.readi-1.1
Hayakawa, A., Kajiwara, T., Ouchi, H., & Watanabe, T. (2022). JADES: New text simplification dataset in Japanese targeted at non-native speakers. In Proceedings of the Workshop on Text Simplification, Accessibility, and Readability (TSAR-2022) (pp. 179–187). Association for Computational Linguistics.
Katsuta, A., & Yamamoto, K. (2018). Crowdsourced corpus of sentence simplification with core vocabulary. In Proceedings of the Eleventh International Conference on Language Resources and Evaluation (LREC 2018). European Language Resources Association.
Laban, P., Vig, J., Kryscinski, W., Joty, S., Xiong, C., & Wu, C.-S. (2023). SWiPE: A dataset for document-level simplification of Wikipedia pages. In Proceedings of the 61st Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers) (pp. 10674–10695). Association for Computational Linguistics. https://doi.org/10.18653/v1/2023.acl-long.596
Maddela, M., & Alva-Manchego, F. (2025). Adapting sentence-level automatic metrics for document-level simplification evaluation. In Proceedings of the 2025 Conference of the Nations of the Americas Chapter of the Association for Computational Linguistics: Human Language Technologies (Volume 1: Long Papers) (pp. 6444–6459). Association for Computational Linguistics. https://doi.org/10.18653/v1/2025.naacl-long.327
Maddela, M., Dou, Y., Heineman, D., & Xu, W. (2023). LENS: A learnable evaluation metric for text simplification. In Proceedings of the 61st Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers) (pp. 16383–16408). Association for Computational Linguistics. https://doi.org/10.18653/v1/2023.acl-long.905
Maruyama, T., & Yamamoto, K. (2018). Simplified corpus with core vocabulary. In Proceedings of the Eleventh International Conference on Language Resources and Evaluation (LREC 2018). European Language Resources Association.
Nagai, Y., Oka, T., & Komachi, M. (2024). A document-level text simplification dataset for Japanese. In Proceedings of the 2024 Joint International Conference on Computational Linguistics, Language Resources and Evaluation (LREC-COLING 2024) (pp. 459–476). ELRA and ICCL. https://aclanthology.org/2024.lrec-main.41
Nohejl, A., Hayakawa, A., Ide, Y., & Watanabe, T. (2024). Difficult for whom? A study of Japanese lexical complexity. In Proceedings of the Third Workshop on Text Simplification, Accessibility and Readability (TSAR 2024) (pp. 69–81). Association for Computational Linguistics. https://aclanthology.org/2024.tsar-1.8
Nohejl, A., Hayakawa, A., Ide, Y., & Watanabe, T. (2025). A Japanese dataset and efficient multilingual LLM-based methods for lexical simplification and lexical complexity prediction. Journal of Natural Language Processing, 32(4), 1129–1188. https://doi.org/10.5715/jnlp.32.1129
Scialom, T., Dray, P.-A., Gallinari, P., Lamprier, S., Piwowarski, B., Staiano, J., & Wang, A. (2021). QuestEval: Summarization asks for fact-based evaluation. In Proceedings of the 2021 Conference on Empirical Methods in Natural Language Processing (pp. 6594–6604). Association for Computational Linguistics. https://doi.org/10.18653/v1/2021.emnlp-main.529
Shardlow, M., Alva-Manchego, F., Batista-Navarro, R., Bott, S., Calderon Ramirez, S., Cardon, R., François, T., Hayakawa, A., Horbach, A., Hülsing, A., Ide, Y., Imperial, J. M., Nohejl, A., North, K., Occhipinti, L., Peréz Rojas, N., Raihan, N., Ranasinghe, T., Solis Salazar, M., … Saggion, H. (2024). An extensible massively multilingual lexical simplification pipeline dataset using the MultiLS framework. In Proceedings of the 3rd Workshop on Tools and Resources for People with REAding DIfficulties (READI) @ LREC-COLING 2024 (pp. 38–46). ELRA and ICCL. https://aclanthology.org/2024.readi-1.4
Sun, R., Jin, H., & Wan, X. (2021). Document-level text simplification: Dataset, criteria and baseline. In Proceedings of the 2021 Conference on Empirical Methods in Natural Language Processing (pp. 7997–8013). Association for Computational Linguistics. https://doi.org/10.18653/v1/2021.emnlp-main.630
Vásquez-Rodríguez, L., Shardlow, M., Przybyła, P., & Ananiadou, S. (2023). Document-level text simplification with coherence evaluation. In Proceedings of the Second Workshop on Text Simplification, Accessibility and Readability (pp. 85–101). INCOMA Ltd.
Xu, W., Napoles, C., Pavlick, E., Chen, Q., & Callison-Burch, C. (2016). Optimizing statistical machine translation for text simplification. Transactions of the Association for Computational Linguistics, 4, 401–415. https://doi.org/10.1162/tacl_a_00107
Yamashita, I., Tanaka, H., Kiyama, H., Bian, K., Chen, Z., & Komachi, M. (2026). Evaluation of document-level text simplification in Japanese. In Proceedings of the Fifteenth Language Resources and Evaluation Conference (LREC 2026) (pp. 1092–1109). ELRA Language Resources Association. https://doi.org/10.63317/23krjsuxizo3
SNSシェア
いいね